RAG Nedir? Yapay Zekanın Doğru Cevap Vermesinin Sırrı

Table of Contents
Giriş: RAG Neden Bu Kadar Çok Konuşuluyor?
RAG nedir sorusu, yapay zeka destekli araçları günlük iş akışına dahil eden kullanıcıların başında sıkça geçiyor. Geri bildirimle zenginleştirilmiş üretim (Retrieval Augmented Generation), bir dil modelinin kendi eğitim verisinin sınırlarını aşarak güncel, doğru ve kaynakları belli yanıtlar üretmesini sağlayan bir mimari. Teknolojinin adı ilk başta karmaşık gelse de mantığı oldukça basit: Yapay zekaya bir soru sorulmadan önce, ilgili bilgiler bir bilgi havuzundan bulunur ve bu bilgiler modele bağlanır. Sonuç ise hem güncel hem de doğrulanmış bir yanıt olur.
Bu mimariyi daha somut bir örnekle canlandırmak istersek, hayali ama sektörde sıkça karşılaştığımız mükemmeliyetçi bir editör karakterini düşünelim. Masasında her gün onlarca makaleyi değerlendiren, “bu kaynağı nereden aldın?”, “tarihi güncel mi?” ve “cümleyi yeniden yaz, böyle olmaz” diyen bir yönetici. Böyle bir editörle çalışan bir asistan, önce doğru kaynağı bulur, sonra o kaynağı doğru şekilde kullanır ve nihayetinde talebe uygun bir metin sunar. İşte RAG da tam olarak böyle çalışır — önce doğru bilgiyi arar, sonra onu üretime dahil eder.
RAG’ın Arkasındaki Fikir: Neden Sadece Model Yeterli Değil?
Doğal dil modelleri (LLM) büyük veri setlerinde eğitilir ve bu süreçte devasa bir bilgi birikimi edinir. Ancak bu modellerin iki temel sınırı vardır. İlki, bilgilerin eğitim verisinin kesinti noktasına kadar güncel olmasıdır. Yani model, eğitimden sonra ortaya çıkan yeni gelişmelerden, ürün güncellemelerinden veya son dakika olaylarından habersiz olabilir. İkinci sorun ise halüsinasyon olarak bilinen durum; model, emin olmadığı bir konuda kendince ikna edici ama gerçeğe uymayan bilgiler üretebilir.
Bu iki zayıf nokta, kurumsal ve teknik ortamlarda ciddi riskler yaratır. Bir müşteri hizmetleri botunun tarihi yanlış bir fiyat vermesi, hukuki bir metnin uydurma bir madde içermesi veya teknik bir sorunun ikna edici ama hatalı cevaplanması, güvenilirliği sıfıra indirebilir. RAG, tam da bu boşluğu doldurmak için ortaya çıkar. Modelin “bilmediği şeyi bilmiyorum” demesini sağlayarak, asıl bilgiyi ise gerçek bir kaynaktan çekerek verir.
RAG Nasıl Çalışır? Adım Adım İşleyiş
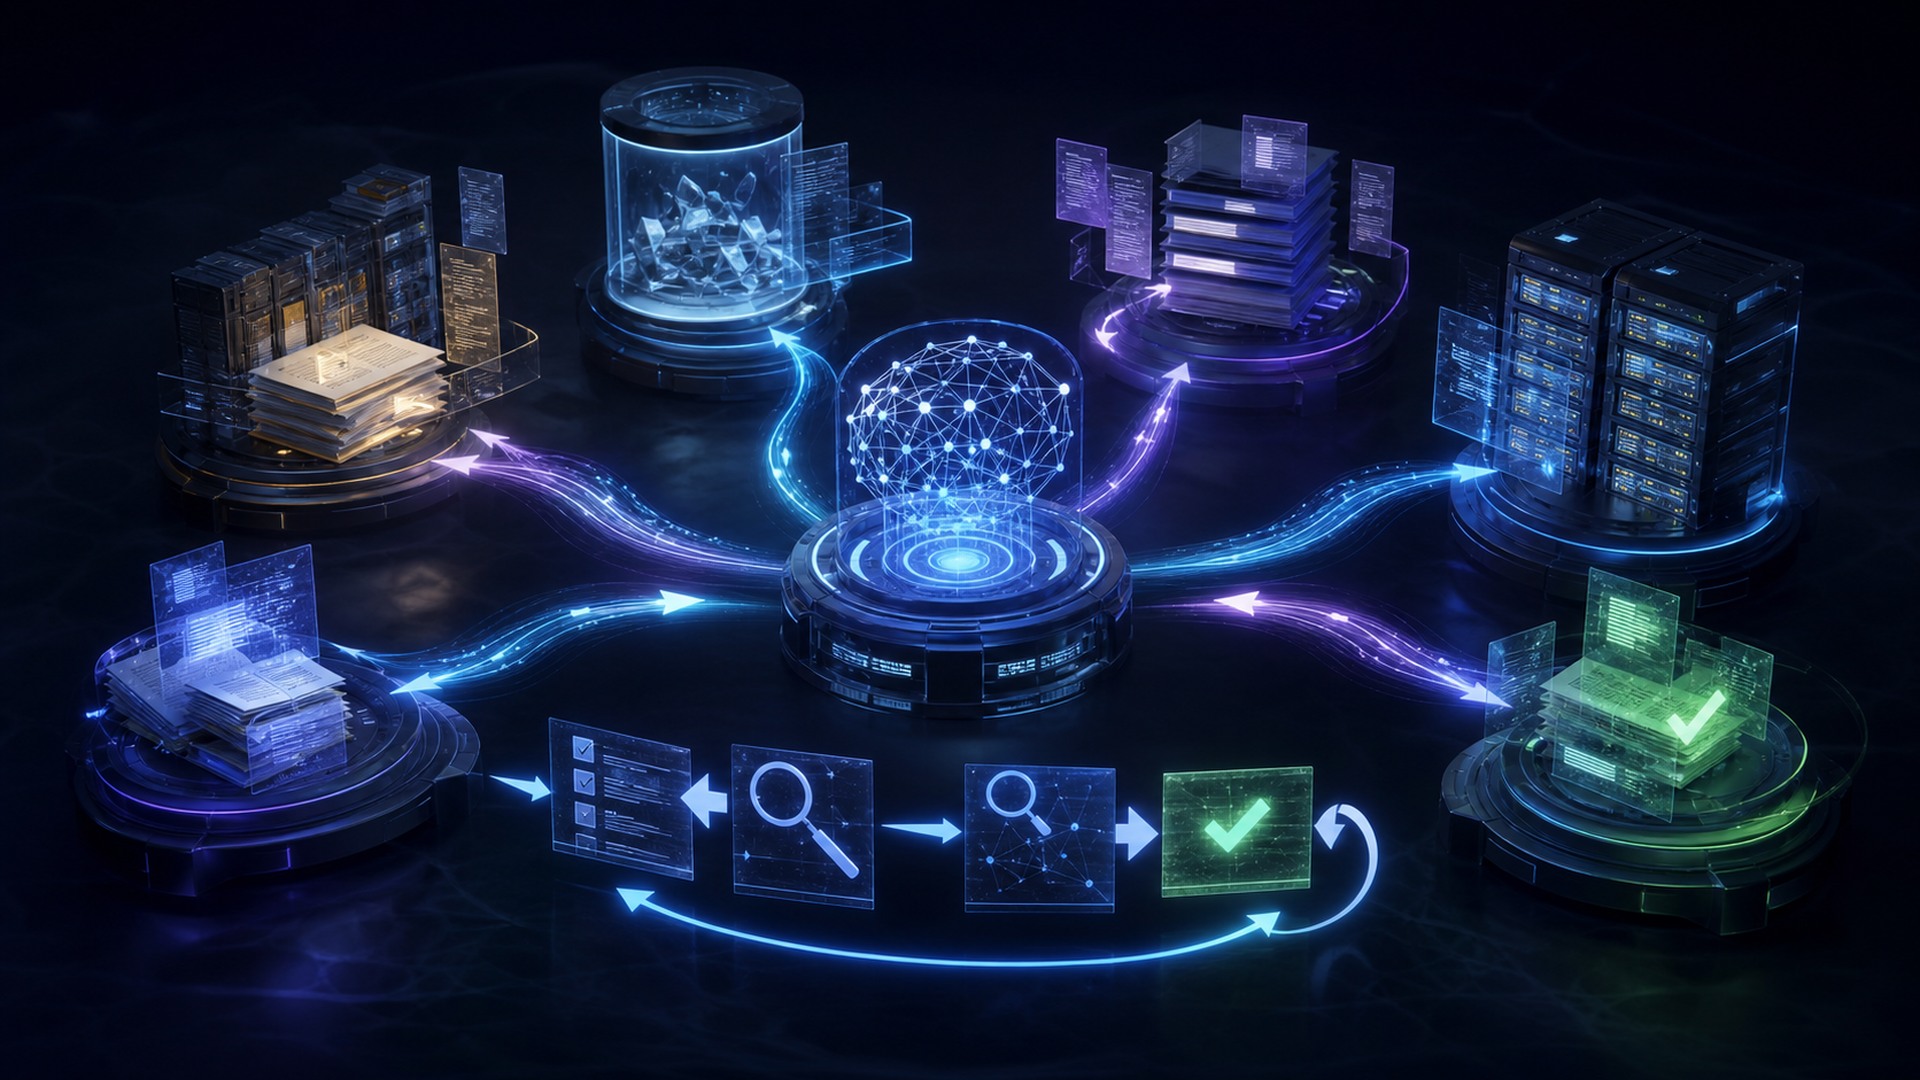
RAG sisteminin temel akışı üç ana aşamadan oluşur. Bu aşamaları bir kütüphaneci ve bir yazarın işbirliği gibi düşünebilirsiniz: kütüphaneci ilgili kitapları bulur, yazar ise bu bilgileri kullanarak metni yazar.
1. Toplama ve İşleme (Indexing): Öncelikle, sistemde kullanılacak ham veriler (PDF’ler, web sayfaları, iç dokümanlar, veri tabanları) toplanır. Bu metinler küçük parçalara ayrılır ve her parça sayısal bir gösterime, yani veköre (embedding) dönüştürülür. Vekörler, metnin anlamını matematiksel vektörlerle temsil eder; böylece benzer anlamlı metinler uzayda birbirine yakın konumlanır.
2. Geri Bildirim (Retrieval): Kullanıcı bir soru sorduğunda, bu soru da aynı şekilde veköre dönüştürülür. Sistem, sorunun vekörünü bilgi havuzundaki vekörlerle karşılaştırır ve en alakalı birkaç belge parçasını bulur. Bu aşamada özel arama motorları veya vektör veri tabanları kullanılır.
3. Üretim (Generation): Bulunan ilgili belgeler, kullanıcının sorusuyla birlikte dil modeline bağlanır. Model artık sadece kendi iç bilgisine değil, aynı zamanda temin edilmiş gerçek bilgilere dayanarak yanıt üretir. Çıktı, hem modelin dil becerisini hem de sağlanan kaynağın doğruluğunu birleştirir.
Sistemin Temel Bileşenleri
Etkili bir RAG kurulumu, uyumlu çalışan birkaç bileşenin bir araya gelmesiyle oluşur. Her bileşenin doğru ayarlanması, nihai yanıtın kalitesini doğrudan etkiler.
- Veri Kaynakları: Sistemin beslendiği ham bilgiler. Metin, tablo, resim açıklaması gibi çeşitli formatlar burada yer alır.
- Parçalama (Chunking): Uzun metinlerin anlamlı parçalara bölünmesi işlemidir. Parçaların boyutu ve aşırı kapanması (overlap), geri bildirin kalitesini belirler.
- Vekörleştirici (Embedding Model): Metni sayısal gösterime çeviren ve anlam benzerliğini yakalayan modeldir.
- Vektör Veri Tabanı: Binlerce veya milyonlarca vekörü hızlıca saklayan ve benzerlik araması yapan depodur.
- Dil Modeli: Geribildirimle zenginleştirilmiş bilgiyi okuyup okunanı kullanarak yanıt üreten kısmdır.
- Yönlendirici (Router) ve Sıkılaştırıcı (Reranker): Arama sonucunu iyileştirerek en alakalı belgeleri öne çıkaran yardımcı bileşenlerdir.
Sadece Dil Modeli ile RAG Arasındaki Fark
İki yaklaşım arasındaki farkı net görmek için, tipik bir yanıttırma senaryosunu karşılaştıralım.
| Özellik | Sadece Dil Modeli | RAG ile |
|—|—|—|
| Bilgi kaynağı | Eğitim verisi (sınırlı, eski) | Canlı/güncel bilgi havuzu |
| Kaynak gösterimi | Genellikle yok | Evet, belgeler referans verilir |
| Halüsinasyon riski | Yüksek | Daha düşük |
| Alan bilgisie (ör. şirket içi veri) | Sınırlı | Yüksek |
| Güncellik | Eğitime kadar | Veri ne kadar güncelse ona göre |
| Maliyet ve gecikme | Düşük | Ek arama maliyeti ve zaman |
| Kişiselleştirme | Zor | Kolay |
Bu tabloda da görüleceği gibi, RAG ek bir işlem maliyeti ve gecikme getirse de, doğruluk ve güncellik açısından sade bir modelden belirgin üstünlük sağlar.
RAG’ın Sağladığı Başlıca Avantajlar
Bu mimarinin popülerliğinin ardında yatan pratik nedenler var. Öne çıkan faydalar şunlardır:
- Daha Doğru Yanıtlar: Model, spekülasyon yerine temin edilmiş veriye dayanır.
- Kaynak Şeffaflığı: Verilen cevapların hangi belgeden geldiği gösterilebilir, bu da denetim ve güven için kritikir.
- Güncel Bilgi: Bilgi havuzu düzenli olarak güncellendiğinde, yanıtlar da güncel kalır.
- Özel Veri Kullanımı: Şirketin kendi dokümanları, politika dosyaları veya ürün verileri kolayca entegre edilir.
- Maliyet Optimizasyonu: Modelin her seferinde devasa bir bağlam (context) okuması gerekmediği için kaynak verimliliği artar.
Dikkat Edilmesi Gereken Zorluklar
RAG güçlü bir araç olsa da, kusursuz değildir. Düzgün yapılandırılmadığında beklenen kaliteyi vermeyebilir. Karşılaşılan başlıca zorluklar şunlardır:
- Kalitesiz Geri Bildirim: Doğru soruya alakasız belge bulunursa, yanıt da yanlış yöne sapar. Buna “çöp gir çöp çık” (garbage in, garbage out) prensibi denir.
- Parçalama Stratejisi: Yanlış boyutta veya kopuk parçalar, bağlamın kaybelmesine neden olur.
- Bağlam Pencerisi Sınırı: Çok sayıda belge eklendiğinde modelin işleyebileceği uzunluk aşılabilir.
- Gecikme ve Maliyet: Ek arama ve işleme adımları, yanııt süresini artırabilir.
- Güncel Olmayan Havuz: Veri kaynağı güncellenmediğinde RAG da eski bilgi verir; bu, sistemin sürekli bakım gerektirdiğini gösterir.
Hangi Durumlarda RAG Gerçekten İşe Yarar?
Bu mimari, bilgiye dayalı ve doğruluk gerektiren tüm alanlarda değer yaratır. Yaygın kullanım alanları şunlardır:
- Müşteri Hizmetleri Botları: Ürün kılavuzları ve SSS verilerine dayanarak anlık destek.
- Kurumsal Bilgi Asistanları: Çalışanların şirket içi dokümanlarında hızlı arama yapması.
- Hukuki ve Finansal Analiz: Güncel mevzuat ve raporlara dayalı özetleme.
- Eğitim Araçları: Doğrulanmış kaynaklara dayalı öğrenme içerikleri.
- Teknik Destek: Hata ayıklama kılavuzlarından adım adım çözüm önerileri.
Bu noktada, RAG’ın tek başına bir çözüm değil, daha geniş bir yapay zeka mimarisinin parçası olduğunu vurgulamak gerekir. Örneğin, kullanıcıyı doğru servise yönlendiren ve birden fazla aracı kullanan yapay zeka ajanları ile RAG bir araya geldiğinde sistem çok daha yetkin hale gelir. Benzer şekilde, güvenlik kritik olan ortamlarda yapay zeka destekli kuralların da bu bilgi tabanlı yaklaşımla desteklenmesi, tehditlere karşı alınabilecek en iyi önlemlerden birini oluşturur.
RAG’ı Etkili Kullanmak İçin Stratejiler
Sistemin kalitesini artırmak için izlenebilecek pratik adımlar vardır:
- Doğru Parçalama: Metin yapısına göre anlamlı ve örtüşen parçalar seçin.
- Sıkılaştırıcı (Reranker) Kullanımı: İlk arama sonuçlarını tekrar derecelendirerek en alakalıları öne çıkarın.
- Meta Veri Filtreleme: Tarih, bölüm veya tür gibi filtreslerle aramayı daraltın.
- Sürekli İzleme: Yanıt kalitesini düzenli olarak değerlendirin ve kötü sonuçları analiz edin.
- Havuzu Güncel Tutun: Kaynak verilerin zamanında yenilenmesini sağlayın.
SSS
RAG ile fine-tuning (ayarlama) arasındaki fark nedir?
Fine-tuning, modelin kendi ağırlıklarının özel verilerle güncellenmesidir. RAG ise modeli eğitmeksizin, yanıt üretmeden önce dış bir bilgi havuzundan veri çeker. Bu nedenle RAG, güncel bilgi ve kaynak şeffaflığı gerektiğinde daha esnek bir çözümdür.
RAG tüm yapay zeka uygulamaları için uygun mudur?
Hayır. Basit sohbet veya yaratıcı metin üretim işlerinde ek arama maliyeti gereksiz olabilir. Doğruluk, güncellik ve kaynak gösterimi kritik olduğunda RAG büyük avantaj sağlar.
Küçük işletmeler için RAG uygulanabilir mi?
Evet. Açık kaynak vekör veri tabanları ve bulut tabanlı arama hizmetleri sayesinde, büyük bütçeler olmadan da temel bir RAG altyapısı kurmak mümkündür. Özellikle kendi ürün veya hizmet verisini kullanmak isteyen işletmeler için uygun bir seçenektir.
RAG halüsinasyonları tamamen ortadan kaldırır mı?
Önemli ölçüde azaltır ancak sıfırlamaz. Yanlış parçalama veya alakasız geri bildirim durumunda hatalı yanıtlar hâlâ görülebilir. Bu nedenle kaynak şeffaflığı ve sürekli izleme önemlidir.
Geri bildirim kalitesini nasıl ölçerim?
Yanıt doğruluğu, kaynak alaka düzeyi ve bağlam tutarlılığını değerlendiren değerlendirme kriterleri (ör. RAGAS gibi çerçeveler) kullanabilirsiniz. Ayrıca gerçek kullanıcı geri bildirimleri de sistemin iyileştirilmesinde rehber olur.
İlgili içerikler: Yeni Üst Düzey Alan Adları (nTLD) Nedir? • Cache Nedir? Web Siteleri İçin Önbellek Rehberi • XSS Nedir? Cross Site Scripting Saldırılarından Korunma Rehberi